 agent-radar
1a3a4ccde1
Creator App Tests / PR Spam Gate (push) Skipped
Frontend Tests / PR Spam Gate (push) Skipped
NPM Format (website & console) / PR Spam Gate (push) Skipped
Pre-commit Checks / PR Spam Gate (push) Skipped
QwenPaw Creator Plugin Release / check-version (push) Canceled after 0s
QwenPaw Creator Plugin Release / upload-oss (push) Canceled after 0s
Tests / PR Spam Gate (push) Skipped
CodeQL / CodeQL (python) (push) Canceled after 0s
CodeQL / CodeQL (typescript) (push) Canceled after 0s
Creator App Tests / Creator Backend Tests (push) Canceled after 0s
Creator App Tests / Creator UI Build & Tests (push) Canceled after 0s
E2E Smoke Tests / Playwright UI Smoke (push) Canceled after 0s
Frontend Tests / Detect console changes (push) Canceled after 0s
NPM Format (website & console) / website format check (push) Canceled after 0s
NPM Format (website & console) / console format check (push) Canceled after 0s
Pre-commit Checks / Pre-commit (push) Canceled after 0s
QwenPaw Data Plugin Release / check-version (push) Canceled after 0s
Tests / Detect code changes (push) Canceled after 0s
Frontend Tests / Vitest Unit Tests (push) Canceled after 0s
Frontend Tests / Frontend Summary (push) Canceled after 0s
QwenPaw Data Plugin Release / upload-oss (push) Canceled after 0s
Tests / Maintainer Approval (push) Canceled after 0s
Tests / Unit Tests - py3.11 - macos-latest (push) Canceled after 0s
Tests / Unit Tests - py3.11 - ubuntu-latest (push) Canceled after 0s
Tests / Unit Tests - py3.13 - ubuntu-latest (push) Canceled after 0s
Tests / Unit Tests - py3.11 - windows-latest (push) Canceled after 0s
Tests / Contract Tests - py3.11 - macos-latest (push) Canceled after 0s
Tests / Contract Tests - py3.11 - ubuntu-latest (push) Canceled after 0s
Tests / Contract Tests - py3.13 - ubuntu-latest (push) Canceled after 0s
Tests / Contract Tests - py3.11 - windows-latest (push) Canceled after 0s
Tests / Integrated Tests - py3.11 - macos-latest - p0 (push) Canceled after 0s
Tests / Integrated Tests - py3.11 - macos-latest - p1 (push) Canceled after 0s
Tests / Integrated Tests - py3.11 - macos-latest - p2 (push) Canceled after 0s
Tests / Integrated Tests - py3.11 - ubuntu-latest - fallback (push) Canceled after 0s
Tests / Integrated Tests - py3.11 - ubuntu-latest - p0 (push) Canceled after 0s
Tests / Integrated Tests - py3.11 - ubuntu-latest - p1 (push) Canceled after 0s
Tests / Integrated Tests - py3.11 - ubuntu-latest - p2 (push) Canceled after 0s
Tests / Integrated Tests - py3.13 - ubuntu-latest - p0 (push) Canceled after 0s
Tests / Integrated Tests - py3.13 - ubuntu-latest - p1 (push) Canceled after 0s
Tests / Integrated Tests - py3.13 - ubuntu-latest - p2 (push) Canceled after 0s
Tests / Integrated Tests - py3.11 - windows-latest - p0 (push) Canceled after 0s
Tests / Integrated Tests - py3.11 - windows-latest - p1 (push) Canceled after 0s
Tests / Integrated Tests - py3.11 - windows-latest - p2 (push) Canceled after 0s
Tests / Coverage Report (push) Canceled after 0s
Tests / Test Summary (push) Canceled after 0s
450 lines
31 KiB
Markdown
450 lines
31 KiB
Markdown
# 长期记忆
|
||
|
||
QwenPaw 的长期记忆由工作区的文件系统和 [ReMe](https://github.com/agentscope-ai/ReMe) 个人知识库共同组成。其中,`MEMORY.md` 可由用户和 Agent 共同维护并按需读取;ReMe 则在后台把值得保留的对话和当前已接入的资料整理成结构化的 Markdown 记忆,逐步沉淀为个人知识库,并在需要时找回与当前问题有关的部分。
|
||
|
||
简单来说,它像一位不会忘记研究过程、又能随时翻出证据的研究助理,主要做六件事:
|
||
|
||
1. **记录**:从对话中留下偏好、事实、判断、理由和待验证假设;
|
||
2. **引入**:从已接入的外部数据源补充论文等资料;
|
||
3. **整理**:把不同日期的零散记录沉淀为长期知识;
|
||
4. **连接**:用来源链接和 Wikilink 串起公司、产业链、结论与证据;
|
||
5. **找回**:通过关键词、语义和知识关系找到真正相关的内容;
|
||
6. **展开**:先返回最相关的片段,证据不足时再沿文件和链接继续阅读。
|
||
|
||
<p align="center">
|
||
<img src="https://img.alicdn.com/imgextra/i3/O1CN01mG5Uot1GQdX33v4h4_!!6000000000617-55-tps-1200-640.svg" alt="QwenPaw 长期记忆从记录、整理到找回的完整循环" />
|
||
</p>
|
||
|
||
## 先理解它怎样工作
|
||
|
||
假设你是一名金融分析师,正在持续研究新能源汽车产业链。几周内,你可能先后讨论过宁德时代的产品结构、动力电池价格、碳酸锂供需,以及“锂价下跌究竟利好电池厂还是会带来库存减值”这样的判断。
|
||
|
||
这些信息如果只留在聊天记录里,很快就会被新的行情和新闻淹没。QwenPaw 的长期记忆会保留当时的研究现场,把反复验证的结论沉淀为个人知识库,并在下一次写报告时找回相关证据。
|
||
|
||
### 1. 记忆首先是你拥有的文件
|
||
|
||
QwenPaw 和 ReMe 遵循 **Memory as File, File as Memory**。记忆不是藏在不可见的数据库中,而是保存在 Agent workspace 里的普通文件:
|
||
|
||
```text
|
||
workspace/
|
||
├── MEMORY.md # 少量、稳定的核心长期记忆
|
||
├── memory/
|
||
│ ├── 2026-08-14.md # 当天记忆笔记的自动索引页
|
||
│ └── 2026-08-14/
|
||
│ ├── 宁德时代盈利讨论.md # 一个 session 对应的一条记忆笔记
|
||
│ └── 锂价敏感性分析.md
|
||
├── digest/
|
||
│ ├── personal/ # 个人偏好、关注范围与长期约定
|
||
│ ├── procedure/ # 可复用的研究流程
|
||
│ └── wiki/ # 公司、行业、指标等知识
|
||
├── mem_session/ # 可追溯的来源对话
|
||
├── resource/ # PDF 等原始资料
|
||
└── mem_metadata/ # 可重建的索引、图谱与缓存
|
||
```
|
||
|
||
| 对象或机制 | 定位与维护方式 | 读取或检索方式 |
|
||
| ------------------------------------ | ----------------------------------------------------------------------------------------------------------- | ----------------------------------------------------------------------- |
|
||
| `MEMORY.md` | QwenPaw 管理的核心长期记忆;用户和主会话中的 Agent 都可以自由读取、编辑和更新 | 通过文件工具按需读取;不属于 ReMe 的 `memory_search` 索引 |
|
||
| `memory/YYYY-MM-DD.md` | 当天所有记忆笔记的索引页;ReMe 自动维护 `<!-- notes:auto -->` 区块,用户和主 Agent 可在自动区块之外补充内容 | 属于个人知识库,可被 `memory_search` 找到;也可直接读取并沿索引继续展开 |
|
||
| `memory/YYYY-MM-DD/{name}.md` | Auto-Memory 为一个 session 创建或更新的一条记忆笔记;`name` 是模型生成的稳定主题或事件名 | 属于个人知识库;主 Agent 通常不需要主动管理 |
|
||
| `digest/` 中的所有 `.md` | ReMe 管理的长期个人知识库;分为 `personal`、`procedure` 和 `wiki` 三类,并用 Wikilink 相互连接 | 属于 `memory_search` 的检索范围,可沿图谱继续展开 |
|
||
| `memory/` + `digest/` 中的所有 `.md` | ReMe 个人知识库的完整文件范围:`memory/` 保存每日现场,`digest/` 保存跨时间整理后的知识 | `memory_search` 的完整检索范围 |
|
||
| `memory_search` 返回的片段 | 当前问题最相关的局部内容,并附带文件路径 | 片段不足时使用 `read_file` 按路径渐进式展开,只读取当前任务所需内容 |
|
||
|
||
此外,`mem_session/` 保存可追溯的来源对话,`resource/` 保存 Daily Paper 下载的 PDF 等原始资料,`mem_metadata/` 保存可重建的索引、图谱和缓存。
|
||
|
||
<p align="center">
|
||
<img src="https://img.alicdn.com/imgextra/i3/O1CN01vwIbuJ1zAkVDvcYjh_!!6000000006674-55-tps-1200-640.svg" alt="Markdown 记忆文件连接长期知识和原始证据" />
|
||
</p>
|
||
|
||
这意味着你可以直接查看、修改、备份或迁移记忆。Markdown 文件是事实来源;搜索索引和图谱只是派生状态,损坏后可以从文件重新构建。`MEMORY.md` 不由 Auto-Memory 或 Auto-Dream 自动覆盖,适合保持短小、稳定的信息。
|
||
|
||
一条关于新能源汽车产业链的长期记忆可能长这样:
|
||
|
||
```markdown
|
||
---
|
||
name: 新能源汽车产业链
|
||
description: 跟踪整车需求、动力电池盈利与上游锂资源的传导关系。
|
||
---
|
||
|
||
# 新能源汽车产业链
|
||
|
||
需求从整车销量传导到动力电池排产,再影响正极材料和锂资源需求。
|
||
|
||
- 代表性电池企业:[[digest/wiki/宁德时代.md]]
|
||
- 关键成本项:[[digest/wiki/碳酸锂.md]]
|
||
- 分析方法:[[digest/procedure/动力电池盈利敏感性分析.md]]
|
||
|
||
## Sources
|
||
|
||
- [[memory/2026-08-14/锂价敏感性分析.md]]
|
||
```
|
||
|
||
正文保存知识,frontmatter 提供概要,`[[...]]` 则连接来源和相关节点。上例中,“新能源汽车产业链”到“宁德时代”是一条**出边(outlink)**;系统同时建立反向索引,因此从“宁德时代”也能看到谁引用了它,这就是**入边(inlink)**。作者只需写一次链接,检索时便可以双向行走:既能从行业走到公司,也能从公司回到它所在的产业链和研究记录。
|
||
|
||
#### Markdown 怎样变成可检索片段
|
||
|
||
ReMe 不是简单地“每隔固定字符切一刀”。索引器会先解析 frontmatter,再把 Markdown 构造成 AST(抽象语法树):标题按层级形成 section,段落、列表、表格和代码块成为叶子节点。随后它按树递归切分,并尽量合并同一父标题下相邻的小块。
|
||
|
||
这样做有三个直接好处:
|
||
|
||
- **语义不被截断**:`## 宁德时代` 下的毛利率讨论尽量留在同一片段;
|
||
- **上下文不丢失**:片段会携带必要的祖先标题 breadcrumb,即使单独召回也知道它属于哪一章;
|
||
- **结构仍然有效**:超长表格按行切分并重复表头,超长列表按条目切分,代码块保留围栏;每个片段保留原文件路径和行号。
|
||
|
||
Wikilink 则独立抽取成文件图谱。最终,一个 Markdown 文件同时贡献了“用于 BM25/向量检索的片段”和“用于关系展开的边”。标题特别多的超大文档会回退为纯文本分块,避免构建 AST 带来不必要的开销。
|
||
|
||
### 2. Auto-Memory 从对话中留下有用的事
|
||
|
||
Auto-Memory 不会复制整段聊天,而是周期性识别以后仍可能有用的内容,例如:
|
||
|
||
- 稳定偏好与长期约定;
|
||
- 项目背景和限制条件;
|
||
- 已确认的决定及其原因;
|
||
- 当前进展、阻塞项与下一步;
|
||
- 可以复用的流程和排查经验。
|
||
|
||
例如,你说“先把宁德时代加入重点跟踪;当前假设是碳酸锂价格下跌有利于电芯单位成本,但还要检查库存减值和价格联动”,它会保留研究对象、当前判断、限制条件、待验证项和来源,而不是把一句临时观点直接写成永久事实。
|
||
|
||
默认每累计 5 个用户回合触发一次。发生上下文淘汰或折叠时,尚未处理的对话也会先进入同一条记忆流程。若没有值得新增或更新的内容,本次运行不会制造空记忆,也不会发送 Inbox 事件。
|
||
|
||
Auto-Memory 会把来源会话写入哈希命名的 JSONL 文件,并在当天的日期目录中为这个 session 创建或更新一条记忆笔记:
|
||
|
||
```text
|
||
mem_session/dialog/qpsid_sha256_<64-hex>.jsonl
|
||
memory/2026-08-14.md
|
||
memory/2026-08-14/锂价敏感性分析.md
|
||
```
|
||
|
||
这里需要区分“索引页”和“记忆笔记”:`memory/2026-08-14.md` 是 ReMe 根据 `memory/2026-08-14/*.md` 自动刷新的索引页;真正从对话中总结出的内容写在日期子目录的笔记里。索引页的实际结构类似下面这样:
|
||
|
||
```text
|
||
---
|
||
name: 2026-08-14
|
||
description: 2 note(s) today.
|
||
---
|
||
|
||
<!-- notes:auto -->
|
||
- [[memory/2026-08-14/宁德时代盈利讨论.md]] name: 宁德时代盈利讨论 description: 跟踪动力与储能业务的量、价、成本驱动。
|
||
- [[memory/2026-08-14/锂价敏感性分析.md]] name: 锂价敏感性分析 description: 分析锂价下跌对电芯成本、售价与库存减值的影响。
|
||
<!-- /notes:auto -->
|
||
```
|
||
|
||
索引的每一行来自对应笔记的 frontmatter:除了链接,还会展示 `name`、`description` 和其他业务字段;用于内部关联的 `session_id`、`source_conversation` 等字段不会出现在索引行中。`notes:auto` 标记之间的内容会在刷新时整体重建,因此不应手工编辑;索引页已有的 frontmatter 和自动区块之外的正文会被保留。
|
||
|
||
日期子目录中的 `{name}.md` 才是 Auto-Memory 生成的 session 记忆。首次处理一个 session 时,系统最多创建一条笔记,并写入 `session_id` 与指向原始 JSONL 的 `source_conversation`;同一天再次处理该 session 时,会通过这两个字段找到原笔记并合并更新,而不是再按对话中的多个话题拆出多份文件。如果 frontmatter 中的 `name` 被优化,文件也会随之安全重命名并更新链接。换句话说,日期文件像当天研究底稿的自动目录,子目录中的文件才是一张张研究底稿。
|
||
|
||
例如,“锂价敏感性分析”笔记会保留类似这样的可追溯信息:
|
||
|
||
```markdown
|
||
---
|
||
name: 锂价敏感性分析
|
||
description: 分析锂价下跌对电芯成本、售价与库存减值的影响。
|
||
session_id: qpsid_sha256_<64-hex>
|
||
source_conversation: "[[mem_session/dialog/qpsid_sha256_<64-hex>.jsonl]]"
|
||
---
|
||
|
||
## 当前判断
|
||
|
||
锂价下跌通常降低电芯材料成本,但仍需检查售价联动速度和高价库存减值。
|
||
```
|
||
|
||
自动召回的旧记忆会在抽取前移除,避免把“刚找回的内容”误当成用户新提供的事实。
|
||
|
||
<p align="center">
|
||
<img src="https://img.alicdn.com/imgextra/i3/O1CN01q1761gvctQB49nzS_!!6000000007099-0-tps-2048-414.jpg" alt="Auto-Memory 完成后推送到 Inbox 的任务结果" />
|
||
</p>
|
||
|
||
Inbox 只用于查看运行结果;真正可编辑、可复用的记忆仍然是 workspace 中的文件。
|
||
|
||
### 3. Auto Resource(Beta)从外部补充知识
|
||
|
||
分析师的知识不只来自对话,还来自论文、新闻和数据源。Auto Resource 是这条外部资料管线的总称,目前仍处于 Beta,正在持续扩展。
|
||
|
||
当前内置能力是 **Daily Paper**:启用后,QwenPaw 会从 Hugging Face Papers 的周榜和月榜中筛选与你关注主题相关的热门论文,保存原始 PDF,并生成三篇精读和一份每日简报。例如把主题设置为 `battery, lithium, energy storage`,就可以持续补充电池材料、寿命预测和储能技术相关研究。
|
||
|
||
- PDF 写入 `resource/papers/`;
|
||
- 精读和简报写入 `memory/YYYY-MM-DD/`;
|
||
- Markdown 阅读记录进入普通记忆索引,也能继续参与长期整理。
|
||
|
||
<p align="center">
|
||
<img src="https://img.alicdn.com/imgextra/i4/O1CN01P4HuDOo3HjE3MD24_!!6000000007223-0-tps-1654-670.jpg" alt="Daily Paper 的调度与主题配置" />
|
||
</p>
|
||
|
||
Daily Paper 是当前内置的资料入口。任意文件仅仅放进 `resource/` 并不会被自动处理。自动抓取你感兴趣的财经新闻并沉淀到知识库仍在规划中(TODO);在正式接入前,不应把 Auto Resource 理解成一个通用的文件导入器。
|
||
|
||
### 4. Auto-Dream 把每日记录整理成长期经验
|
||
|
||
只有 daily note 还不够。随着记录越来越多,Auto-Dream 会扫描近期发生变化的每日记忆,把可复用内容整合到 `digest/`。
|
||
|
||
#### 先分成三类记忆
|
||
|
||
Auto-Dream 首先判断一条信息属于哪种长期记忆。三种类型不仅对应不同目录,也决定最终笔记应该怎样表达:
|
||
|
||
| 记忆类型 | 保存内容与写法 | 金融分析师示例 |
|
||
| ----------- | -------------------------------------------------------- | ---------------------------------------- |
|
||
| `personal` | 用户的身份、偏好、关注范围和长期约定 | 重点跟踪中国新能源汽车产业链和锂资源公司 |
|
||
| `procedure` | 可复用的操作流程,写成包含步骤、输入和注意事项的 runbook | 动力电池公司盈利敏感性分析流程 |
|
||
| `wiki` | 定义、事实、观察、原则和心智模型,写成简洁的百科知识节点 | 宁德时代、碳酸锂、库存减值及锂价传导机制 |
|
||
|
||
分类之后,关于“我长期研究什么”的内容进入 `personal/`,关于“以后应该怎样分析”的方法进入 `procedure/`,关于“公司、行业和指标是什么、如何相互影响”的知识进入 `wiki/`。这样,Auto-Dream 不是简单压缩日记,而是在把研究记录变成结构清晰、可以复用的个人知识库。
|
||
|
||
#### 再选择四种整理动作
|
||
|
||
确定记忆类型后,Auto-Dream 会检索已有的 digest 节点,判断新材料与旧知识的关系,并且只选择一个动作:
|
||
|
||
| 动作 | 含义 |
|
||
| ------------- | ------------------------------------------ |
|
||
| `CREATE` | 没有相同知识时创建新节点 |
|
||
| `CORROBORATE` | 新材料再次证明已有记忆,补充来源或强化表述 |
|
||
| `REFINE` | 新材料增加步骤、条件、边界或细节 |
|
||
| `CORRECT` | 新材料修正已有节点中的错误、遗漏或冲突 |
|
||
|
||
例如,不同日期的研究记录可能分别写着:“锂价下跌降低正极材料成本”“电芯价格也可能随之下调”“高价库存会造成短期减值压力”。Auto-Dream 不会把其中任何一句孤立地当成结论,而会把它们整合为更有边界的长期知识:
|
||
|
||
> 锂价下跌通常缓解动力电池材料成本,但对宁德时代利润的净影响还取决于售价联动速度、库存成本、客户议价与产品结构,不能只依据锂价方向判断。
|
||
|
||
在这个例子中,如果知识库里还没有“锂价传导机制”,就执行 `CREATE`;如果新的季度数据再次支持原判断,就执行 `CORROBORATE`;如果发现库存周期会改变短期影响,就执行 `REFINE`;如果原来写成“锂价下跌必然利好宁德时代”,则执行 `CORRECT`,把结论收紧到证据能够支持的范围。
|
||
|
||
#### 最后由 Auto-Link 构建记忆图谱
|
||
|
||
Auto-Link 是 Auto-Dream 构建文档图谱的关键。它不是等整理结束后,仅凭文件名机械补链接;在整合每条记忆时,Agent 同时拥有较完整的上下文:
|
||
|
||
- 当前从 daily note 中抽取出的记忆单元,以及对应的来源路径;
|
||
- 搜索召回的现有 `personal`、`procedure` 和 `wiki` 节点;
|
||
- 经过读取后确认的同一知识节点和相关知识节点;
|
||
- 本次准备创建或更新的目标节点及其原有正文。
|
||
|
||
有了这些上下文,Agent 可以先区分“同一知识”和“相关知识”:同一知识决定应该执行四种动作中的哪一种;相关知识则被自然地织入正文,形成有语义的 Wikilink。例如,“锂价变化通过 [[digest/wiki/碳酸锂.md]] 影响 [[digest/wiki/宁德时代.md]] 的材料成本,具体评估可使用 [[digest/procedure/动力电池盈利敏感性分析.md]]。”这比单独罗列几个裸链接更清楚,因为链接周围的文字同时说明了节点之间的关系。
|
||
|
||
每个长期节点还会在 `## Sources` 中用带上下文的 Wikilink 指回 daily note,保留结论到原始材料的证据链;digest 节点之间的 Wikilink 则承载概念图谱。索引器随后从这些链接生成出边和入边,供 Memory Search 渐进式展开。Auto-Dream 不会改写每日记忆:`memory/` 保留“当时看到了什么、怎样判断”,`digest/` 保存“跨时间后仍值得复用的结论”。这就是“让日记长成个人知识库”。
|
||
|
||
<p align="center">
|
||
<img src="https://img.alicdn.com/imgextra/i1/O1CN01ddkg0rN9DXK49o5c_!!6000000001181-0-tps-2048-796.jpg" alt="Auto-Dream 完成后推送到 Inbox 的任务摘要" />
|
||
</p>
|
||
|
||
Auto-Dream 还会生成 `interests.yaml`。它与 QwenPaw 当前的 `/proactive` mode 是独立能力;当前 `/proactive` 不读取该文件。
|
||
|
||
### 5. Memory Search 在需要时找回正确的记忆
|
||
|
||
当你问“锂价下跌对宁德时代是利好吗?”,`memory_search` 不需要重新阅读全部研究历史。它会:
|
||
|
||
1. 用 BM25 找到关键词相符的片段;
|
||
2. 配置 Embedding 后,再找到措辞不同但意思相近的片段;
|
||
3. 用 RRF 融合两组结果;
|
||
4. 为命中文件附上 Wikilink 的出边和入边,供 Agent 按需继续展开。
|
||
|
||
<p align="center">
|
||
<img src="https://img.alicdn.com/imgextra/i2/O1CN01Zln7TK1TJOGqP84hk_!!6000000002361-55-tps-1200-640.svg" alt="BM25 与向量检索融合后按需展开相关记忆" />
|
||
</p>
|
||
|
||
BM25 擅长“宁德时代”“CATL”“碳酸锂”这类明确名称;向量检索可以让“上游原料降价对电芯龙头利润的影响”找到措辞不同的“锂价敏感性分析”。RRF(Reciprocal Rank Fusion)根据两路结果的名次进行融合,避免某一路分数尺度支配最终排序。没有配置 Embedding 时,BM25 和 Wikilink 图谱仍然可用。详细配置见 [向量模型](./embedding)。
|
||
|
||
个人知识库包括 `daily_dir`(默认 `memory/`)和 `digest_dir`(默认 `digest/`)下的所有 Markdown 文件。索引后台只监听这两个目录,每个文件最大 10 MiB。文件会按 Markdown 结构分块,并保留路径和行号;`MEMORY.md`、`resource/` 与 `mem_session/` 不直接进入 ReMe 的 `memory_search`。
|
||
|
||
例如,搜索“锂价下跌如何影响宁德时代盈利”可能返回:
|
||
|
||
```text
|
||
========== digest/wiki/宁德时代.md:18-24 [score=0.0325 vector=0.8120 keyword=8.4700] ==========
|
||
## 锂价与盈利敏感性
|
||
锂价下跌通常降低材料成本,但净影响取决于售价联动、库存成本与产品结构。
|
||
参见 [[digest/wiki/碳酸锂.md]] 和 [[digest/procedure/动力电池盈利敏感性分析.md]]。
|
||
outlinks (2):
|
||
→ digest/wiki/碳酸锂.md name="碳酸锂"
|
||
→ digest/procedure/动力电池盈利敏感性分析.md name="动力电池盈利敏感性分析"
|
||
inlinks (2):
|
||
← digest/wiki/新能源汽车产业链.md name="新能源汽车产业链"
|
||
← memory/2026-08-14/宁德时代盈利讨论.md name="宁德时代盈利讨论"
|
||
```
|
||
|
||
返回结果先给出命中片段的路径和行号,以及关键词、向量和融合排序的相关信息;片段正文可以包含原始 Wikilink。`outlinks` 是命中文档主动引用的下游文档,`inlinks` 是引用命中文档的上游文档。
|
||
|
||
这是一种**渐进式混合搜索**:第一步只拿回最相关的局部片段;如果还不能回答“为什么”,Agent 再用 `read_file` 打开“碳酸锂”或分析流程;如果要核对这条判断何时形成,则沿入边打开 8 月 14 日的讨论。系统不必一开始把整座知识库塞进上下文,却保留了从结论走向概念、方法和原始记录的路径。
|
||
|
||
`MEMORY.md` 通过文件工具按需读取,不依赖 ReMe 搜索。
|
||
|
||
### 完整循环
|
||
|
||
回到金融分析师的例子:
|
||
|
||
1. 你在 `MEMORY.md` 中写下“重点跟踪新能源汽车、锂电池和锂资源”的稳定研究范围;
|
||
2. Auto-Memory 把当天关于宁德时代与锂价的 session 总结成一条日期子目录笔记,并刷新当天索引页;
|
||
3. Auto Resource 把已接入的相关论文精读补充进每日记忆;
|
||
4. Markdown AST 分块、BM25、向量索引与文件图谱在后台持续更新;
|
||
5. Auto-Dream 把多天记录整理成 `personal`、`procedure` 和 `wiki` 长期节点,并建立 Wikilink;
|
||
6. Memory Search 在下一次写研报时先返回命中片段,再按需沿出边、入边和文件路径展开;
|
||
7. 你可以随时检查和修正 Markdown,修改后的内容继续参与后续协作。
|
||
|
||
<p align="center">
|
||
<img src="https://img.alicdn.com/imgextra/i2/O1CN019aX2sCLIZvB6wGdo_!!6000000005818-0-tps-3418-1594.jpg" alt="QwenPaw 长期记忆控制台总览" />
|
||
</p>
|
||
|
||
### 6. 实验效果:历史变长后还能找回来吗?
|
||
|
||
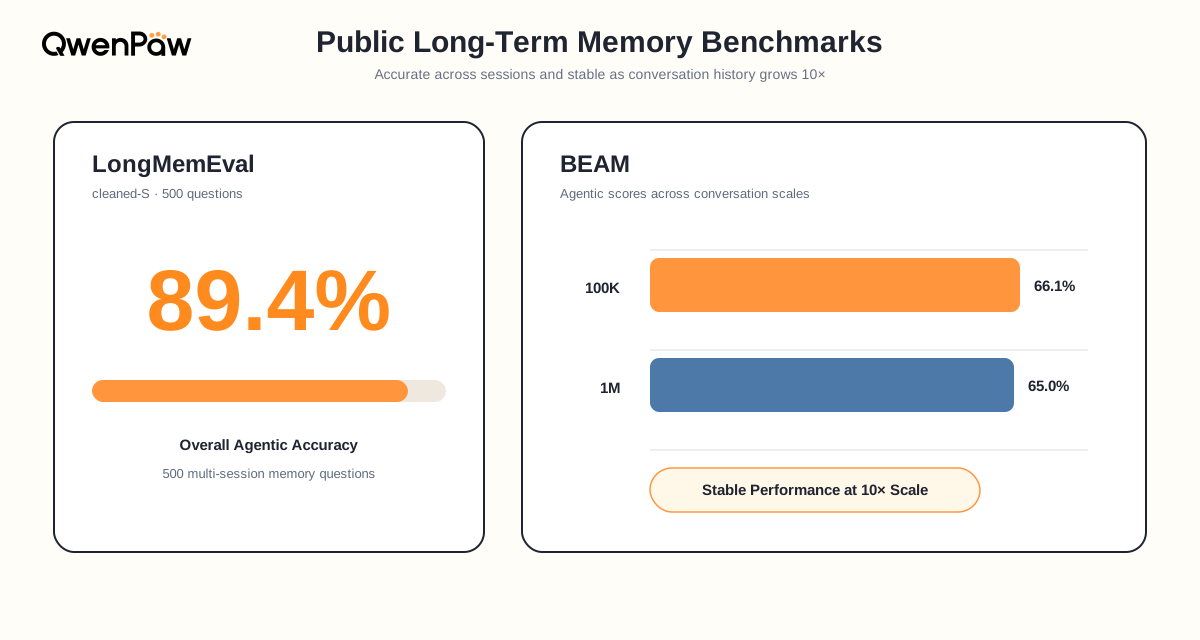
上面的新能源汽车案例用于解释工作方式,不能代替量化评测。ReMe 另外使用公开 benchmark 测试多会话与超长历史中的记忆能力:
|
||
|
||
| Benchmark | 规模 | 整体 Agentic 得分 |
|
||
| --------------------- | -------------------- | ----------------- |
|
||
| LongMemEval cleaned-S | 500 道题 | **89.4%** |
|
||
| BEAM 100K | 20 个案例 / 400 道题 | **66.1%** |
|
||
| BEAM 1M | 35 个案例 / 700 道题 | **65.0%** |
|
||
|
||
|
||
|
||
这些数字不代表每一种真实业务,也会受到模型、数据集和评测设置影响。它们说明的是:即使历史扩展到很长的尺度,文件化整理、混合检索和按需展开仍能帮助 Agent 找到回答依据。完整设置与分项结果见 [LongMemEval benchmark](https://github.com/agentscope-ai/ReMe/tree/main/benchmark/longmemeval) 和 [BEAM benchmark](https://github.com/agentscope-ai/ReMe/tree/main/benchmark/beam)。
|
||
|
||
## 参数配置
|
||
|
||
默认的 `remelight` backend 在 QwenPaw 进程内运行,并复用当前 Agent 的模型完成记忆抽取和整理。你可以在控制台配置,也可以编辑 `agent.json` 中的 `running.reme_light_memory_config`。
|
||
|
||
### 常用配置
|
||
|
||
```json
|
||
{
|
||
"running": {
|
||
"memory_manager_backend": "remelight",
|
||
"reme_light_memory_config": {
|
||
"auto_memory_interval": 5,
|
||
"auto_memory_inbox_push_enabled": true,
|
||
"dream_cron_enabled": true,
|
||
"dream_cron": "0 23 * * *",
|
||
"auto_dream_inbox_push_enabled": true,
|
||
"daily_paper_cron_enabled": false,
|
||
"daily_paper_cron": "0 9 * * *",
|
||
"daily_paper_use_hf_mirror": false,
|
||
"daily_paper_topics": "",
|
||
"daily_paper_inbox_push_enabled": true,
|
||
"memory_search_enabled": true,
|
||
"auto_memory_search_config": {
|
||
"enabled": false,
|
||
"max_results": 2
|
||
}
|
||
}
|
||
}
|
||
}
|
||
```
|
||
|
||
| 配置项 | 默认值 | 说明 |
|
||
| --------------------------------------- | -------------- | ------------------------------------------------------------------ |
|
||
| `auto_memory_interval` | `5` | 每累计 N 个用户回合触发 Auto-Memory;`null` 或 `<= 0` 关闭周期触发 |
|
||
| `auto_memory_inbox_push_enabled` | `true` | Auto-Memory 实际改变记忆或执行失败后推送到 Inbox |
|
||
| `dream_cron_enabled` | `true` | 启用定时 Auto-Dream |
|
||
| `dream_cron` | `"0 23 * * *"` | 五段式 cron;实际运行前会随机延迟 0–60 秒 |
|
||
| `auto_dream_inbox_push_enabled` | `true` | Auto-Dream 实际改变记忆或执行失败后推送到 Inbox |
|
||
| `daily_paper_cron_enabled` | `false` | 启用定时 Daily Paper |
|
||
| `daily_paper_cron` | `"0 9 * * *"` | Daily Paper 的五段式 cron |
|
||
| `daily_paper_use_hf_mirror` | `false` | 通过 Hugging Face 镜像获取论文信息 |
|
||
| `daily_paper_topics` | `""` | 选论文时优先考虑的主题 |
|
||
| `daily_paper_inbox_push_enabled` | `true` | 把 Daily Paper 结果推送到 Inbox |
|
||
| `memory_search_enabled` | `true` | 向 Agent 提供手动 `memory_search` 工具 |
|
||
| `auto_memory_search_config.enabled` | `false` | 每次普通用户请求前自动搜索记忆 |
|
||
| `auto_memory_search_config.max_results` | `2` | 自动搜索时最多注入的结果数 |
|
||
|
||
自动搜索结果只注入当前请求,不写入正式会话历史,也不会再次被 Auto-Memory 保存。自动化产生的请求不会触发自动搜索。
|
||
|
||
### 目录与索引配置
|
||
|
||
| 配置项 | 默认值 | 说明 |
|
||
| ------------------------ | ---------------- | -------------------------------------------- |
|
||
| `metadata_dir` | `"mem_metadata"` | 索引、图谱、catalog 和缓存目录 |
|
||
| `session_dir` | `"mem_session"` | Auto-Memory 来源对话目录 |
|
||
| `mem_session_dir` | `"mem_agent"` | ReMe 内部 memory-agent 会话目录 |
|
||
| `resource_dir` | `"resource"` | Daily Paper 等工作流的原始资源目录 |
|
||
| `daily_dir` | `"memory"` | 每日记忆目录 |
|
||
| `digest_dir` | `"digest"` | 长期知识目录 |
|
||
| `embedding_model_config` | 默认关闭 | 可选向量模型配置,见 [向量模型](./embedding) |
|
||
| `needs_reindex` | `false` | 向量空间变化后由运行时维护的待重建标记 |
|
||
|
||
旧字段 `inbox_push_enabled` 仅用于迁移:它会初始化尚未设置的三个任务级 Inbox 开关,但不会写回已验证的配置。
|
||
|
||
### 状态与重建索引
|
||
|
||
长期记忆页面可以查看后台任务、等待队列、资源占用和索引组件状态。
|
||
|
||
<p align="center">
|
||
<img src="https://img.alicdn.com/imgextra/i3/O1CN01hrPfLUAdE1C2Fz5c_!!6000000006909-0-tps-1112-1312.jpg" alt="ReMe 后台活动、资源占用和索引组件状态" />
|
||
</p>
|
||
|
||
正常的 Markdown 新增和修改会被增量索引。只有在控制台提示向量空间发生变化、索引损坏或搜索明显异常时,才需要使用 **Rebuild Memory Index**,或调用:
|
||
|
||
```http
|
||
POST /api/agents/{agentId}/memory/reindex
|
||
```
|
||
|
||
重建会清空派生索引,再从 `memory/` 和 `digest/` 的 Markdown 生成新索引;不会删除源记忆。运行期间 CPU 和内存占用可能上升,同一个 Agent 同时只能运行一个重建任务。
|
||
|
||
<p align="center">
|
||
<img src="https://img.alicdn.com/imgextra/i3/O1CN01BCTjXC0jfMG1GYA0_!!6000000005728-0-tps-624-276.jpg" alt="重建记忆索引前的资源占用确认提示" />
|
||
</p>
|
||
|
||
---
|
||
|
||
## 其他 Memory Backend
|
||
|
||
QwenPaw 的记忆系统采用可插拔的 Backend 架构。除了默认的 ReMeLight(本地文件存储)外,还支持通过 `memory_manager_backend` 切换到其他后端。
|
||
|
||
### ADBPG(AnalyticDB for PostgreSQL)
|
||
|
||
基于云端向量数据库的长期记忆后端,适合需要跨设备共享、大规模语义检索的场景。QwenPaw 通过 ADBPG 记忆服务的 REST API 接入,无需安装额外数据库驱动。
|
||
|
||
**核心特点:**
|
||
|
||
- **跨会话持久化** — 记忆存储在云端数据库,重启后不丢失,支持多设备共享
|
||
- **服务端事实抽取** — 由 ADBPG 记忆服务完成事实提取,客户端无额外开销
|
||
- **REST API 接入** — 通过 HTTP API 调用 ADBPG 记忆服务
|
||
- **优雅降级** — ADBPG 不可达时 Agent 正常运行,仅长期记忆功能暂时禁用
|
||
|
||
**配置方式:**
|
||
|
||
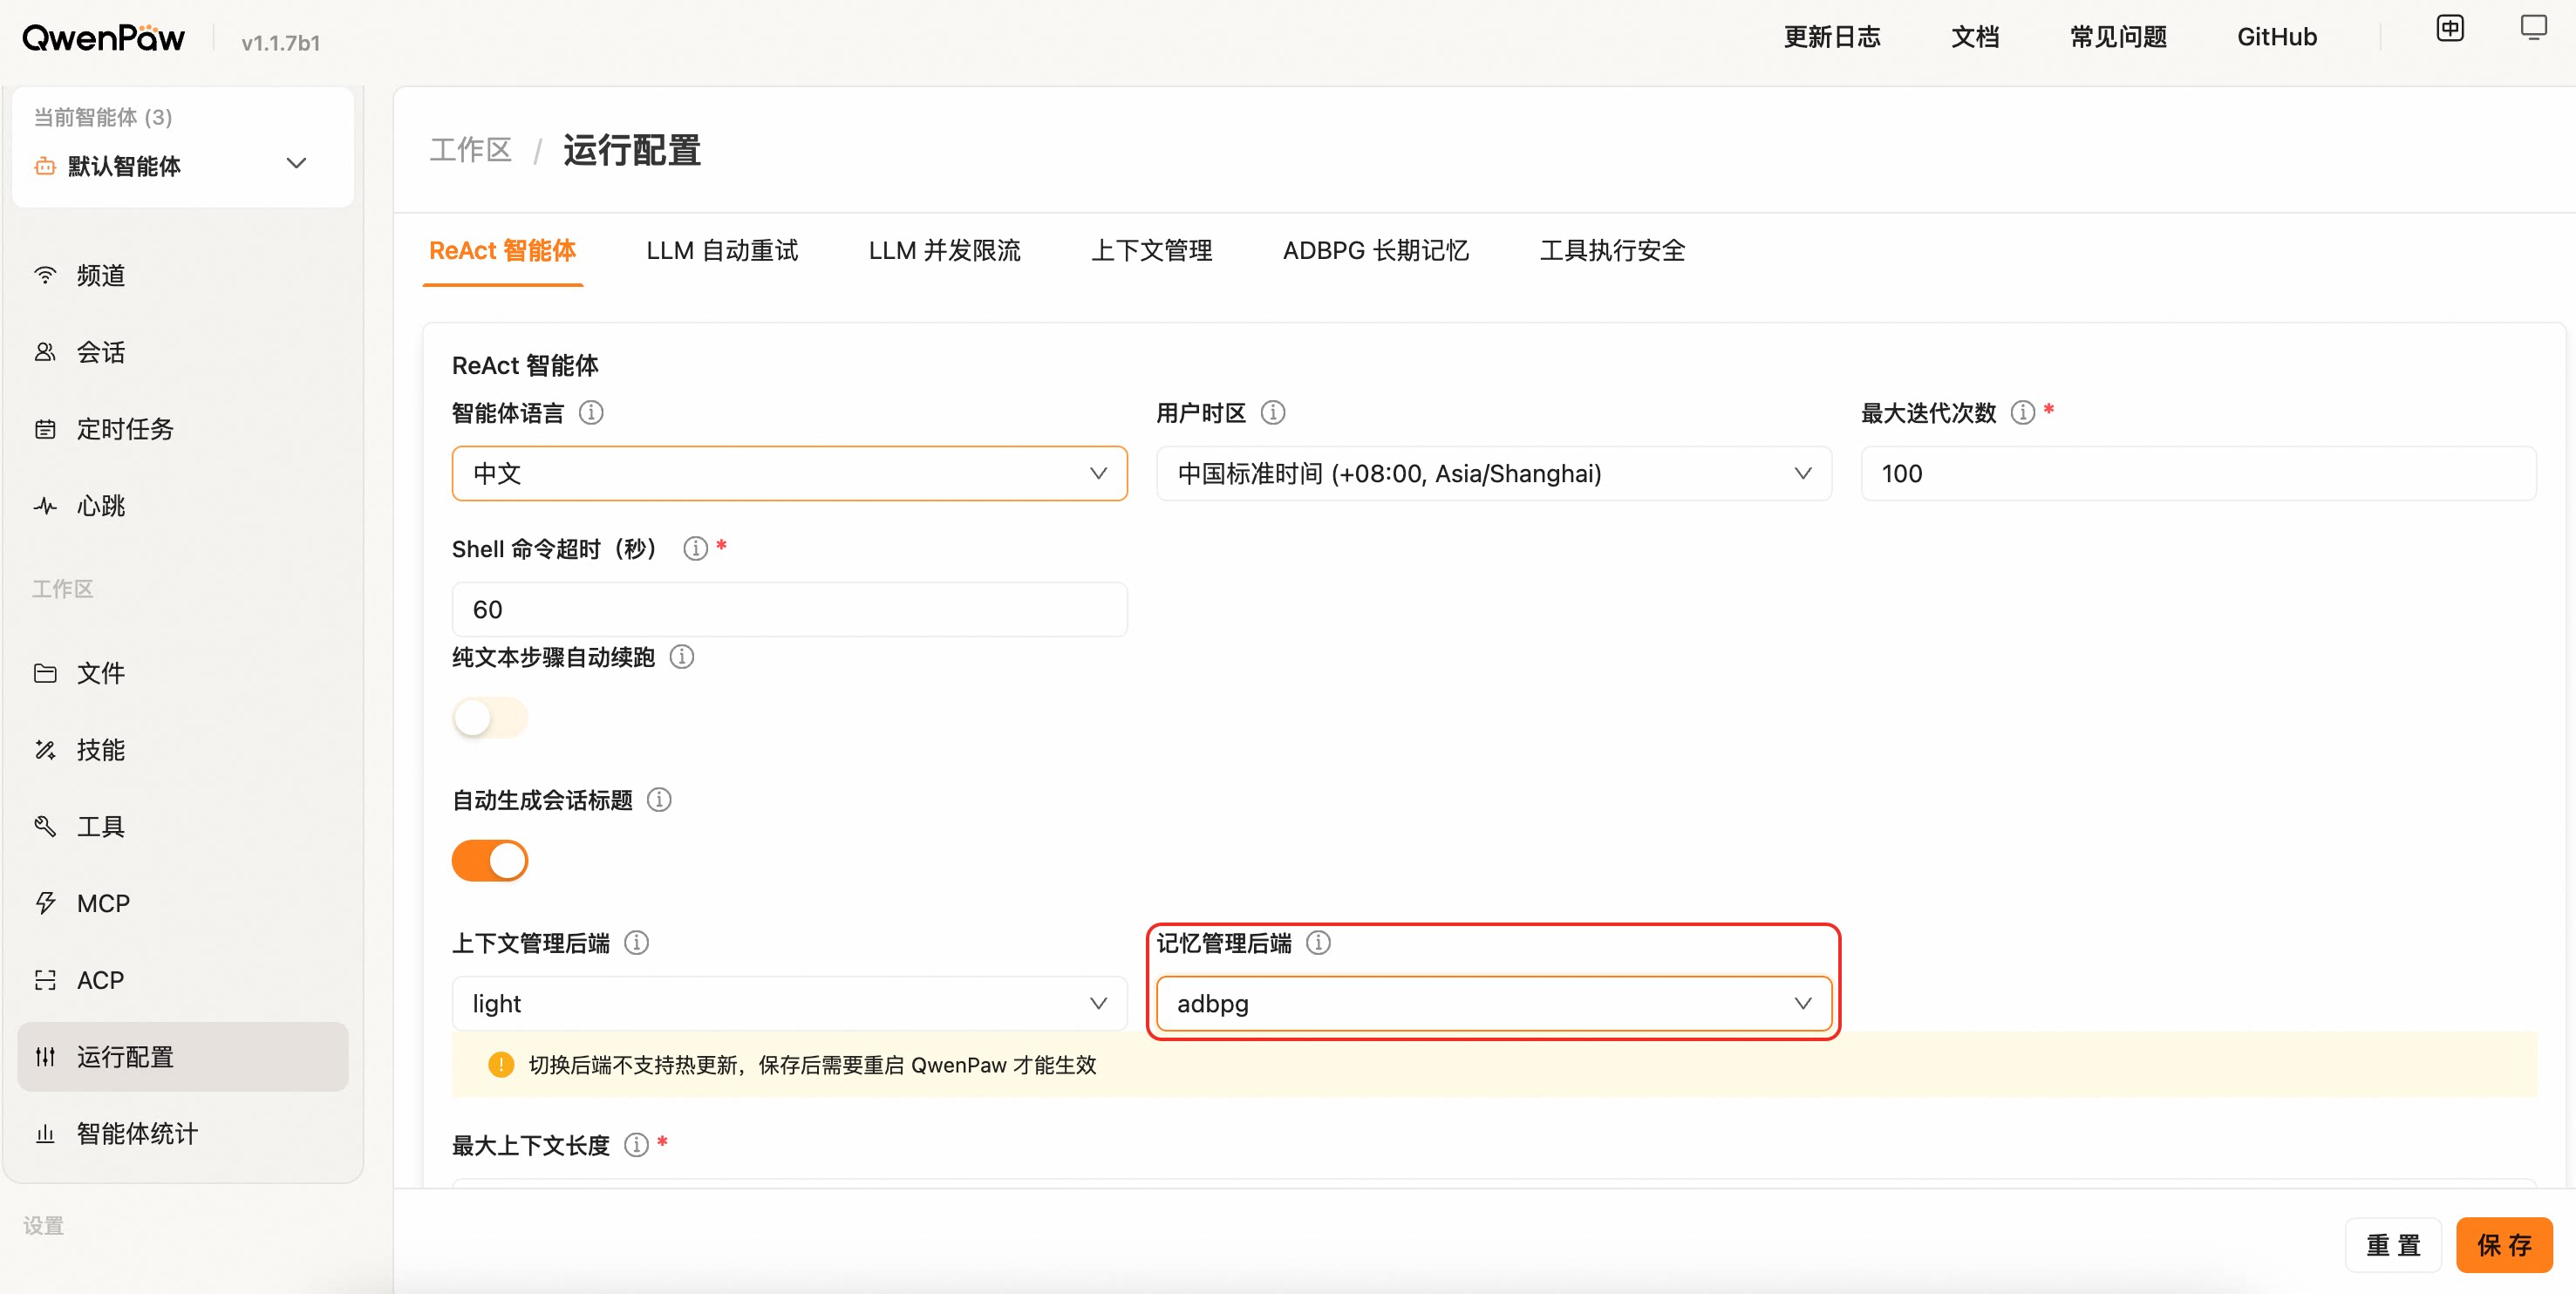
进入 Agent 配置页面的「运行配置」标签,找到「长期记忆管理后端」下拉框,选择 `adbpg`,并在「ADBPG 长期记忆」Tab 中填写 `REST Base URL` 与 `REST API Key`。
|
||
|
||
|
||
|
||
> ⚠️ 切换后端不支持热更新,保存后需要重启 QwenPaw 才能生效(页面也会以黄色横幅提醒)。
|
||
|
||
> 迁移提示:ADBPG SQL 直连模式已移除。旧配置中的 `api_mode: "sql"`、
|
||
> `host`、`port`、`user`、`password`、`dbname`、LLM 和 Embedding 相关字段
|
||
> 会被忽略;请改为配置 `rest_base_url` 和 `rest_api_key`,保存后重启
|
||
> QwenPaw。
|
||
|
||
| 配置项 | 说明 | 默认值 |
|
||
| --------------------------- | ----------------------------------------------------------------------- | ------------------------------------- |
|
||
| `rest_base_url` | ADBPG 记忆服务的 REST API 地址 | `""` |
|
||
| `rest_api_key` | REST API 的访问密钥 | `""` |
|
||
| `memory_isolation` | 记忆隔离模式,`true` 为每个 Agent 独立,`false` 为共享 | `true` |
|
||
| `search_timeout` | 记忆搜索超时时间(秒) | `10.0` |
|
||
| `auto_memory_search_config` | 自动记忆搜索配置,结构与 ReMe Light 的 `auto_memory_search_config` 一致 | `{"enabled": true, "max_results": 3}` |
|
||
|
||
**配置示例:**
|
||
|
||
完整配置可写入 `agent.json` 的 `running.adbpg_memory_config` 字段:
|
||
|
||
```json
|
||
{
|
||
"running": {
|
||
"memory_manager_backend": "adbpg",
|
||
"adbpg_memory_config": {
|
||
"rest_base_url": "https://your-adbpg-memory-api.example.com",
|
||
"rest_api_key": "your-rest-api-key",
|
||
"memory_isolation": true,
|
||
"search_timeout": 10.0,
|
||
"auto_memory_search_config": {
|
||
"enabled": true,
|
||
"max_results": 3
|
||
}
|
||
}
|
||
}
|
||
}
|
||
```
|
||
|
||
> 💡 通过 Console「运行配置」页面填写时,框架会自动将这些字段写入 `agent.json`,无需手动编辑文件。
|
||
|
||
---
|
||
|
||
## 相关页面
|
||
|
||
- [智能体记忆进化](./memory-evolving-and-proactive) — Auto-Memory、Auto-Dream、Auto-Memory-Search 与 Proactive 工作流
|
||
- [向量模型](./embedding) — 向量模型能力、后端、配置与排查
|
||
- [控制台](./console) — 在控制台管理记忆与配置
|
||
- [配置与工作目录](./config) — 工作目录与 Agent 配置
|